2026年度の南山大学 全学統一入試(理系型、2月7日実施)「情報」の過去問について、全問の答えと解き方を図を使って解説します。まず自分で問題を解いてから、答え合わせのつもりで読んでみてください。
あわせて読みたい!
【2027年度入試】南山大学「情報」の傾向と対策
南山大学2026年度「情報」はどんな試験か
南山大学の全学統一入試(理系型)では、「理科・情報」の試験時間は60分です。問題は I と II の2つのグループに分かれていて、Iからは「物理I・化学I・情報I」のどれか1つ、IIからは「物理II・化学II・情報II」のどれか1つを選んで解きます。
ここでいう「情報I」「情報II」は問題の区分の名前で、高校の科目名とは別物です。たとえば「情報I+物理II」のように、情報と理科を組み合わせて受けることもできます。
大学が公表している出題の意図をまとめると、次のようになります。
| 区分 | 題材 | 問われている力(出題の意図より) |
|---|---|---|
| 情報I 問1 | ビット列の表現(符号化) | 信号処理に関する基礎力 |
| 情報I 問2 | 商取引(認証と暗号) | セキュリティに関する基礎力 |
| 情報II | 数列の出力(フローチャート) | アルゴリズムに関する基礎力 |
どの問題も教科書の基本から出ていますが、用語を覚えているだけでは解けない問いもあります。「なぜそうなるのか」を自分の言葉で説明できるかどうかを、解説を読みながら確かめてみましょう。
情報I 問1 符号化(可変長符号・平均符号長・接頭語条件)
この大問のテーマは、「よく出てくる記号には短いビット列を割り当てると、全体が短くなる」というアイデアです。ただし割り当て方を間違えると、受け取った側が元に戻せなくなってしまいます。この2つを順番に確かめていく流れになっています。
問題に出てくる3つの符号表と、各記号が選ばれる確率(表4)を1つにまとめておきます。以下はこの表を見ながら読み進めてください。
| 記号 | 確率(表4) | 表1 | 表2 | 表3 |
|---|---|---|---|---|
| ♠(スペード) | 0.6 | 00 | 0 | 0 |
| ♡(ハート) | 0.25 | 01 | 10 | 10 |
| ◇(ダイヤ) | 0.1 | 10 | 110 | 11 |
| ♣(クラブ) | 0.05 | 11 | 111 | 01 |
(1) 答え:37
2進数を10進数に直すときは、右端の桁から順に 1, 2, 4, 8, 16, 32, 64, 128 という「重み」がついていると考えます。00100101 で1が立っているのは重み32、4、1の桁なので、それを足して37になります。
00100101(2) = 32 + 4 + 1 = 37
(2) 答え:イ 000100100011、ウ 01001100111
記号列 ♠♡♠◇♠♣ を、1文字ずつ表に当てはめてつなげるだけです。表1なら 00, 01, 00, 10, 00, 11 をつなげて12ビット、表2なら 0, 10, 0, 110, 0, 111 をつなげて11ビットになります。この記号列には♠が3回も出てくるので、♠を1ビットにした表2のほうが短くなるわけです。
(3) 答え:より短くなる
表3で同じ記号列を符号化すると、0, 10, 0, 11, 0, 01 で 010011001 の9ビットです。表2の11ビットより短くなります。一見すると表3がいちばん優秀に見えますが、実は欠点があります。それは(8)で明らかになります。
(4) 答え:1.55
表示されるビット列の長さの期待値は、「その記号が選ばれる確率 × その記号のビット数」を4つの記号について足し合わせれば求められます。
表1はどの記号も2ビットなので、期待値は2です。表2にすると、1記号あたり平均0.45ビット節約できることになります。出やすい記号ほど短くするというこの発想は、ハフマン符号という圧縮の方法につながっています。
(5) 答え:誤り検出符号
通信中にノイズで0と1が入れ替わってしまったとき、それに気づくために付け加えるデータを誤り検出符号といいます。代表的なものがパリティビットで、データ中の1の個数が偶数(または奇数)になるように1ビットを付け足しておきます。1ビットだけ反転すると偶奇がずれるので、受信側で誤りに気づけるという仕組みです。
(6) 答え:7ビット
対象の文字は、数字10種類、英字52種類、記号32種類で、合計94種類です。nビットで表せるのは2のn乗通りなので、94通り以上を表せる最小のnを探します。6ビットでは26=64通りしかなく足りませんが、7ビットなら27=128通りあるので足ります。
(7) 答え:スペードの数が、ダイヤとクラブの数の合計より多い記号列
表1から表2に換えると、記号ごとのビット数は次のように変わります。
| 記号 | 表1 | 表2 | 変化 |
|---|---|---|---|
| ♠(スペード) | 2ビット | 1ビット | 1ビット短くなる |
| ♡(ハート) | 2ビット | 2ビット | 変わらない |
| ◇(ダイヤ)、♣(クラブ) | 2ビット | 3ビット | 1ビット長くなる |
つまり、スペードが1個出てくるたびに1ビット得をし、ダイヤやクラブが1個出てくるたびに1ビット損をします。ハートは損も得もしません。得の合計が損の合計を上回ればよいので、「スペードの数 > ダイヤの数 + クラブの数」を満たす記号列なら、表2のほうが短くなります。
(8) 答え:「0110」のように、複数の記号列が同じビット列で表される場合があるから
表3では、スペードの「0」がクラブの「01」の先頭と同じになっています。そのため、受け取ったビット列をどこで区切るかが1通りに決まりません。たとえば「0110」は、0 / 11 / 0 と区切れば「スペード・ダイヤ・スペード」ですが、01 / 10 と区切れば「クラブ・ハート」とも読めてしまいます。
これに対して表2は、どの記号のビット列も、ほかの記号のビット列の先頭にはなっていません。この性質を接頭語条件(語頭条件)といいます。符号を「0なら左、1なら右」に進む木で表すと、この違いがひと目でわかります。
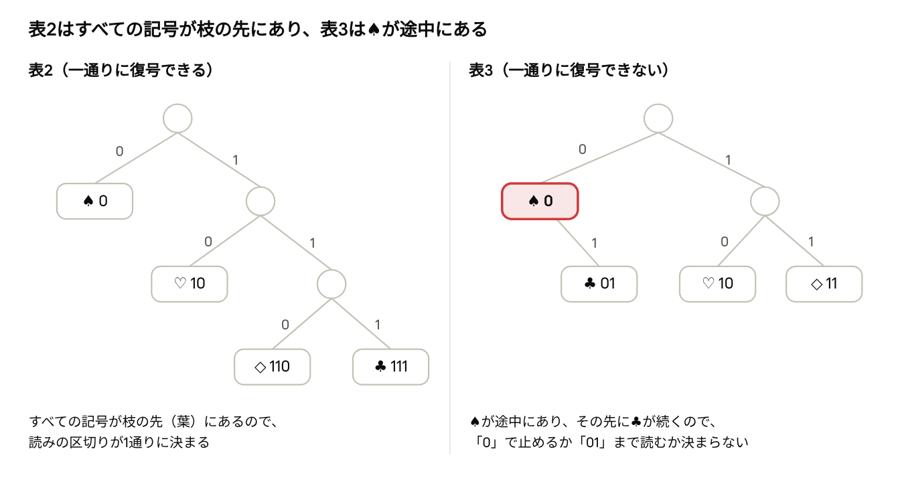
木の上からビットを読んでいき、記号にたどり着いたらそこで区切る、というのが復号の手順です。表2は記号がすべて枝の先にあるので、たどり着いた瞬間に迷わず区切れます。表3は♠にたどり着いてもその先に♣が続いているので、そこで区切るべきかどうかが決まらないのです。
情報I 問2 認証と暗号(二要素認証・デジタル署名・SSL)
インターネットで買い物をするときの「本人確認」と「盗み見の防止」がテーマです。ポイントは2つあります。1つは、認証の要素には3種類あること。もう1つは、「鍵は公開鍵暗号で安全に届けて、本文は速い共通鍵暗号で送る」という考え方です。
(1) 答え:① ユーザID、② パスワード
サービスから割り当てられた、個人を識別するための情報がユーザIDです。本人であることを確認するためにあらかじめ登録しておく文字の並びが、パスワードです。
(2) 答え:ア 生体、イ 所有物
本人確認に使う情報は、大きく3種類に分けられます。この分類が、次の(3)を解くカギになります。
| 要素 | どんなものか | 例 |
|---|---|---|
| 知識情報 | 本人だけが知っていること | パスワード、暗証番号、生年月日 |
| 生体情報 | 本人の体の特徴 | 指紋、顔、静脈 |
| 所有物情報 | 本人だけが持っているもの | スマートフォン、ICカード、カードキー |
(3) 答え:(a) X、(b) Y、(c) X、(d) Z
ここで区別したいのは、「二段階」と「二要素」の違いです。二段階認証は、確認を2回行うこと。二要素認証は、その2回の確認に種類の違う要素を使っていることです。
| 選択肢 | 使うもの | 要素 | 判定 |
|---|---|---|---|
| (a) | パスワード + スマホに届く認証コード | 知識 + 所有物 | X(二要素認証) |
| (b) | パスワード + 生年月日 | 知識 + 知識 | Y(二段階だが二要素ではない) |
| (c) | カードキー + 指紋 | 所有物 + 生体 | X(二要素認証) |
| (d) | 顔の撮影のみ | 生体 | Z(どちらでもない) |
迷いやすいのは(b)です。確認は2回していますが、パスワードも生年月日も「本人が知っていること」なので、同じ種類の要素を2回使っただけです。だから二段階認証ではあっても、二要素認証にはなりません。
(4) 答え:平文
暗号化する前の、誰でも読める状態の通信内容を平文(ひらぶん)といいます。暗号化した後
(5) 答え:(a)、(c)
2つの暗号方式の違いを整理すると、次のようになります。
| 共通鍵暗号方式 | 公開鍵暗号方式 | |
|---|---|---|
| 使う鍵 | 暗号化も復号も同じ鍵 | 受信者の公開鍵で暗号化し、受信者の秘密鍵で復号 |
| 処理の速さ | 速い | 遅い |
| 弱点 | 鍵を安全に渡すのが難しい | 計算に時間がかかる |
(b)が誤りなのは、共通鍵暗号方式が今も使われているから。処理が速いので、このあと(7)で見るSSLでも、本文の暗号化には共通鍵が使われています。(d)は、送信者が「自分の秘密鍵」で暗号文を作っている点が誤りです。公開鍵暗号方式で暗号化に使うのは「受信者の公開鍵」で、受信者は自分の秘密鍵で復号します。
あわせて読みたい!
共通鍵暗号方式と公開鍵暗号方式の違いって?高校「情報Ⅰ」で出る重要用語をわかりやすく解説
(6) 答え:ウ 公開鍵、エ 秘密鍵、オ 公開鍵
デジタル署名は、なりすましや改ざんを防ぐための技術です。(5)の暗号化とは、鍵の使い方が逆になっていることに注目してください。暗号化では「受信者の公開鍵で暗号化し、受信者の秘密鍵で復号」に対して、デジタル署名では「送信者の秘密鍵で暗号化し、送信者の公開鍵で復号」です。
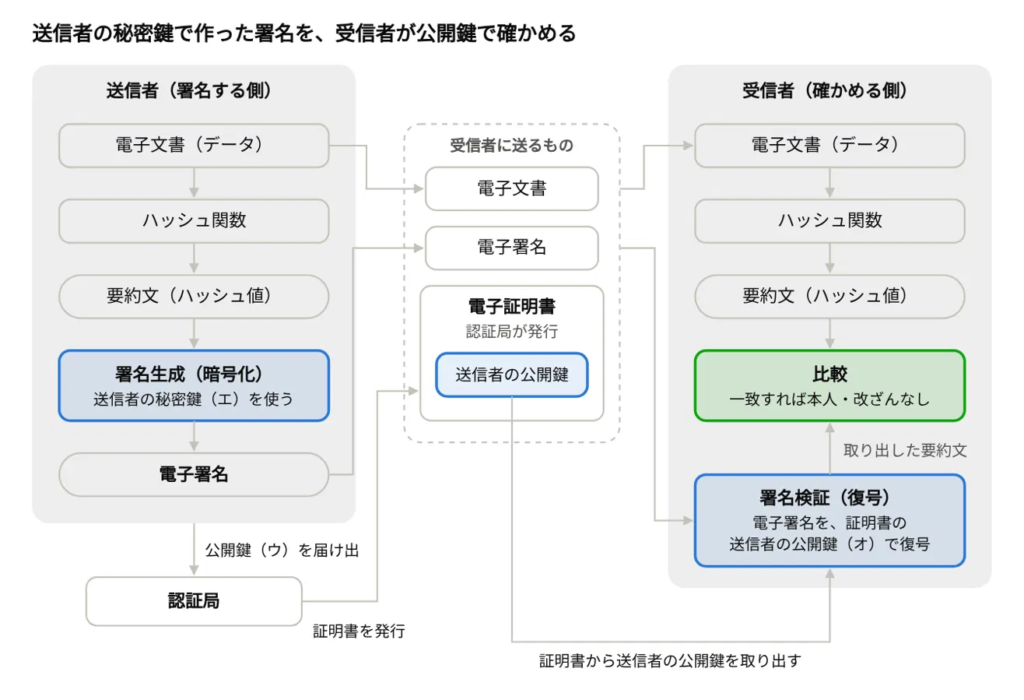
送信者の秘密鍵を持っているのは、送信者本人だけです。その送信者の公開鍵で復号できたということは、本人が作った署名だという証拠になります。さらに、復号した要約文と、受け取ったデータから自分で作った要約文が一致すれば、途中で改ざんされていないことも確かめられます。
(7) 答え:カ 公開鍵、キ 共通鍵、ク 共通鍵、ケ 秘密鍵、コ 共通鍵
SSLは、公開鍵暗号方式と共通鍵暗号方式のいいところを組み合わせた仕組みです。公開鍵暗号方式は鍵を安全に渡せるけれど処理が遅い。共通鍵暗号方式は速いけれど、鍵の渡し方が難しい。そこで、共通鍵だけを公開鍵暗号方式で包んで届け、量の多い本文は共通鍵で暗号化して送るのです。
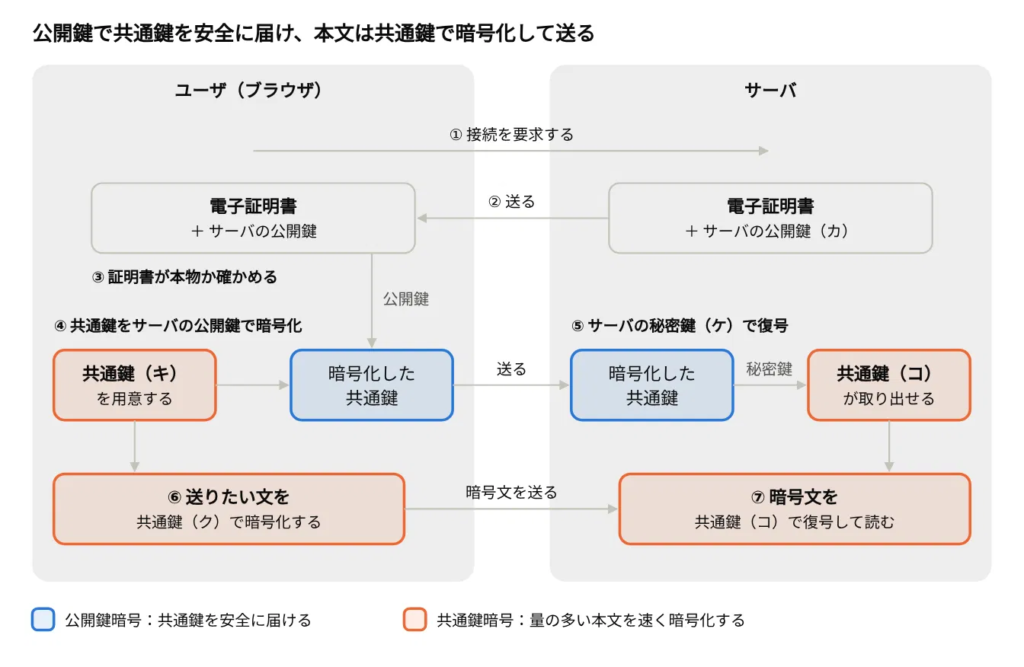
この仕組みが安全なのは、暗号化された共通鍵を元に戻せるのが、秘密鍵を持っているサーバだけだからです。途中で誰かに通信を盗み見られても、共通鍵は取り出せないので、本文も読まれません。空欄で迷ったら、「この鍵は誰のもので、何を包むために使うのか」を図で確かめてみましょう。
情報II フローチャート(くり返し回数・配列の逆順)
同じ数列を出力する手順でも、書き方しだいで処理の回数が大きく変わる、というのがこの大問のテーマです。フローチャートは頭の中だけで追うとミスしやすいので、変数の値を表に書き出しながら進めるのがおすすめです。
アルゴリズムAは、nを1から100まで1ずつ増やしながら、nを3倍した数を出力します。アルゴリズムBは、nを1ずつ増やしながら3で割り切れたときだけnを出力し、出力した個数cが100になったら終わります。どちらも「3の倍数を小さい順に100個」出力する手順ですが、考え方が違います。
問1 答え:AもBも 3, 6, 9, 12, 15, 18, 21, 24, 27, 30
Aは3×1、3×2、3×3…と出力していくので、3の倍数がそのまま並びます。Bは1, 2, 3, 4…と順に調べて、3で割り切れる3, 6, 9…だけを出力します。やり方は違っても、結果は同じになります。
問2 答え:Aは100回、Bは300回
問題では、「nを1大きくする」が実行された回数で数えるよう指定されています。Aはnが1から100までの間くり返すので、100回です。Bは、100個目の3の倍数である300を出力するまで、n=1からn=300まで全部を調べます。その一つひとつで「nを1大きくする」が1回ずつ実行されるので、300回になります。
Bは3の倍数でない1, 2, 4, 5…まで調べるぶん、Aの3倍の回数がかかっているわけです。
問3 答え:① nに3を代入、② nが300以下の間、③ nを3大きくする
図3では、出力の処理が「nを出力」に変わっています。3倍する処理がなくなったので、nそのものを3, 6, 9…と増やしていけばよいです。出力したいのは3から300までなので、nの初期値は3、くり返す条件は「300以下の間」、増やす量は3になります。
n ← 3
n ≦ 300 の間くり返す
    n を出力する
    n ← n + 3
くり返しを考えるときは、このように「初期値」「くり返す条件」「増やす量」の3つをセットで決めると整理しやすくなります。
問4 答え:④ cが100未満の間、⑤ cを1大きくする、⑥ nを2大きくする
求めたいのは「3の倍数だけれど6の倍数ではない数」、つまり3, 9, 15, 21…です。6の倍数は偶数なので、言いかえると「3の倍数のうち奇数のもの」になります。
図4では、nの初期値が1に決まっています。ここからnを2ずつ増やせば、1, 3, 5, 7, 9…と奇数だけを調べられます。その中で3で割り切れるものを出力すれば、ちょうど3, 9, 15…が得られます。あとはアルゴリズムBと同じく、出力するたびにcを1増やし、cが100になったら終わればよいので、④は「cが100未満の間」、⑤は「cを1大きくする」です。
実際に最初の数回を追うと、次のようになります。
| n | 3で割り切れる? | 出力 | この回のあとのc |
|---|---|---|---|
| 1 | No | なし | 0 |
| 3 | Yes | 3 | 1 |
| 5 | No | なし | 1 |
| 7 | No | なし | 1 |
| 9 | Yes | 9 | 2 |
| 11 | No | なし | 2 |
| 13 | No | なし | 2 |
| 15 | Yes | 15 | 3 |
問5 答え:⑦ a[99−c]にnを代入
終了の直前に配列aをa[0]から順に出力したとき、300, 297, …, 6, 3 と逆順に並んでいればよいわけです。つまり、最初に見つかる3は最後の箱a[99]に、最後に見つかる300は先頭の箱a[0]に入れる必要があります。
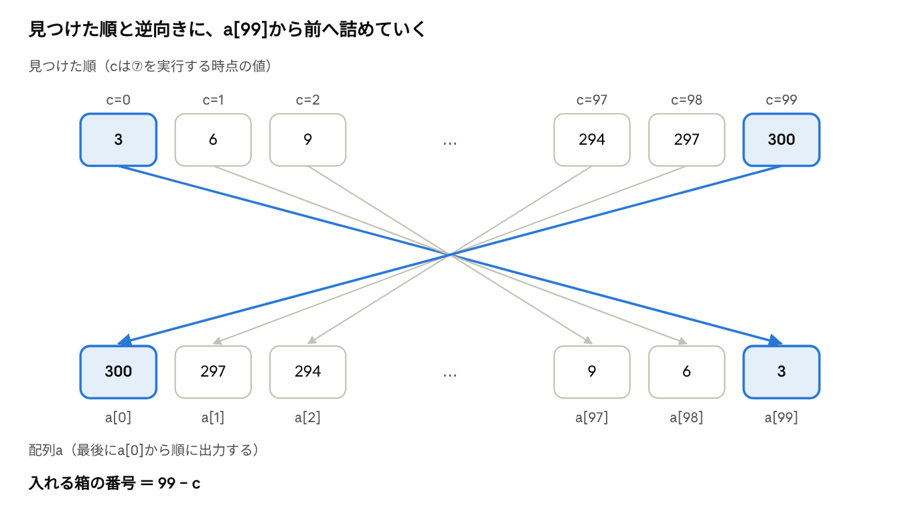
⑦の処理は「cを1大きくする」より前にあるので、⑦を実行する時点のcは、それまでに見つかった個数です。最初の3を見つけたときはc=0なので99−0=99番の箱、次の6のときはc=1なので98番の箱というように、cが1増えるたびに入れる箱が1つずつ前にずれていきます。最後の300のときはc=99なので、0番の箱に入ります。
まとめ:南山大学「情報」の対策ポイント
どの大問も、用語を覚えているかだけでなく、「なぜそうなるのか」を説明できるかが問われていました。
符号化の問題では、符号表を見たら平均ビット数を計算してみること、そしてどの符号もほかの符号の先頭になっていないかを確かめることが大切です。認証と暗号では、「誰の鍵で、何を暗号化しているのか」を図に書いて整理しておくと、暗号化とデジタル署名で鍵の使い方が逆になることも混乱しなくなります。フローチャートでは、変数の値を表に書き出して追いかけ、くり返しの「初期値・条件・増やす量」をセットで考える習慣をつけましょう。
ほかの年度・科目を解きたい人は赤本で
コメント